NVIDIA hizo varios anuncios clave en la última GTC (GPU Technology Conference). En primer lugar, lanzó oficialmente su GPU de IA de nueva generación, la Blackwell B100. Sin embargo, la conferencia principal puso el foco en toda la plataforma Blackwell, no solo en la tarjeta gráfica B100.
ÍndiceMostrarOcultar
El chip Blackwell y la GPU B100
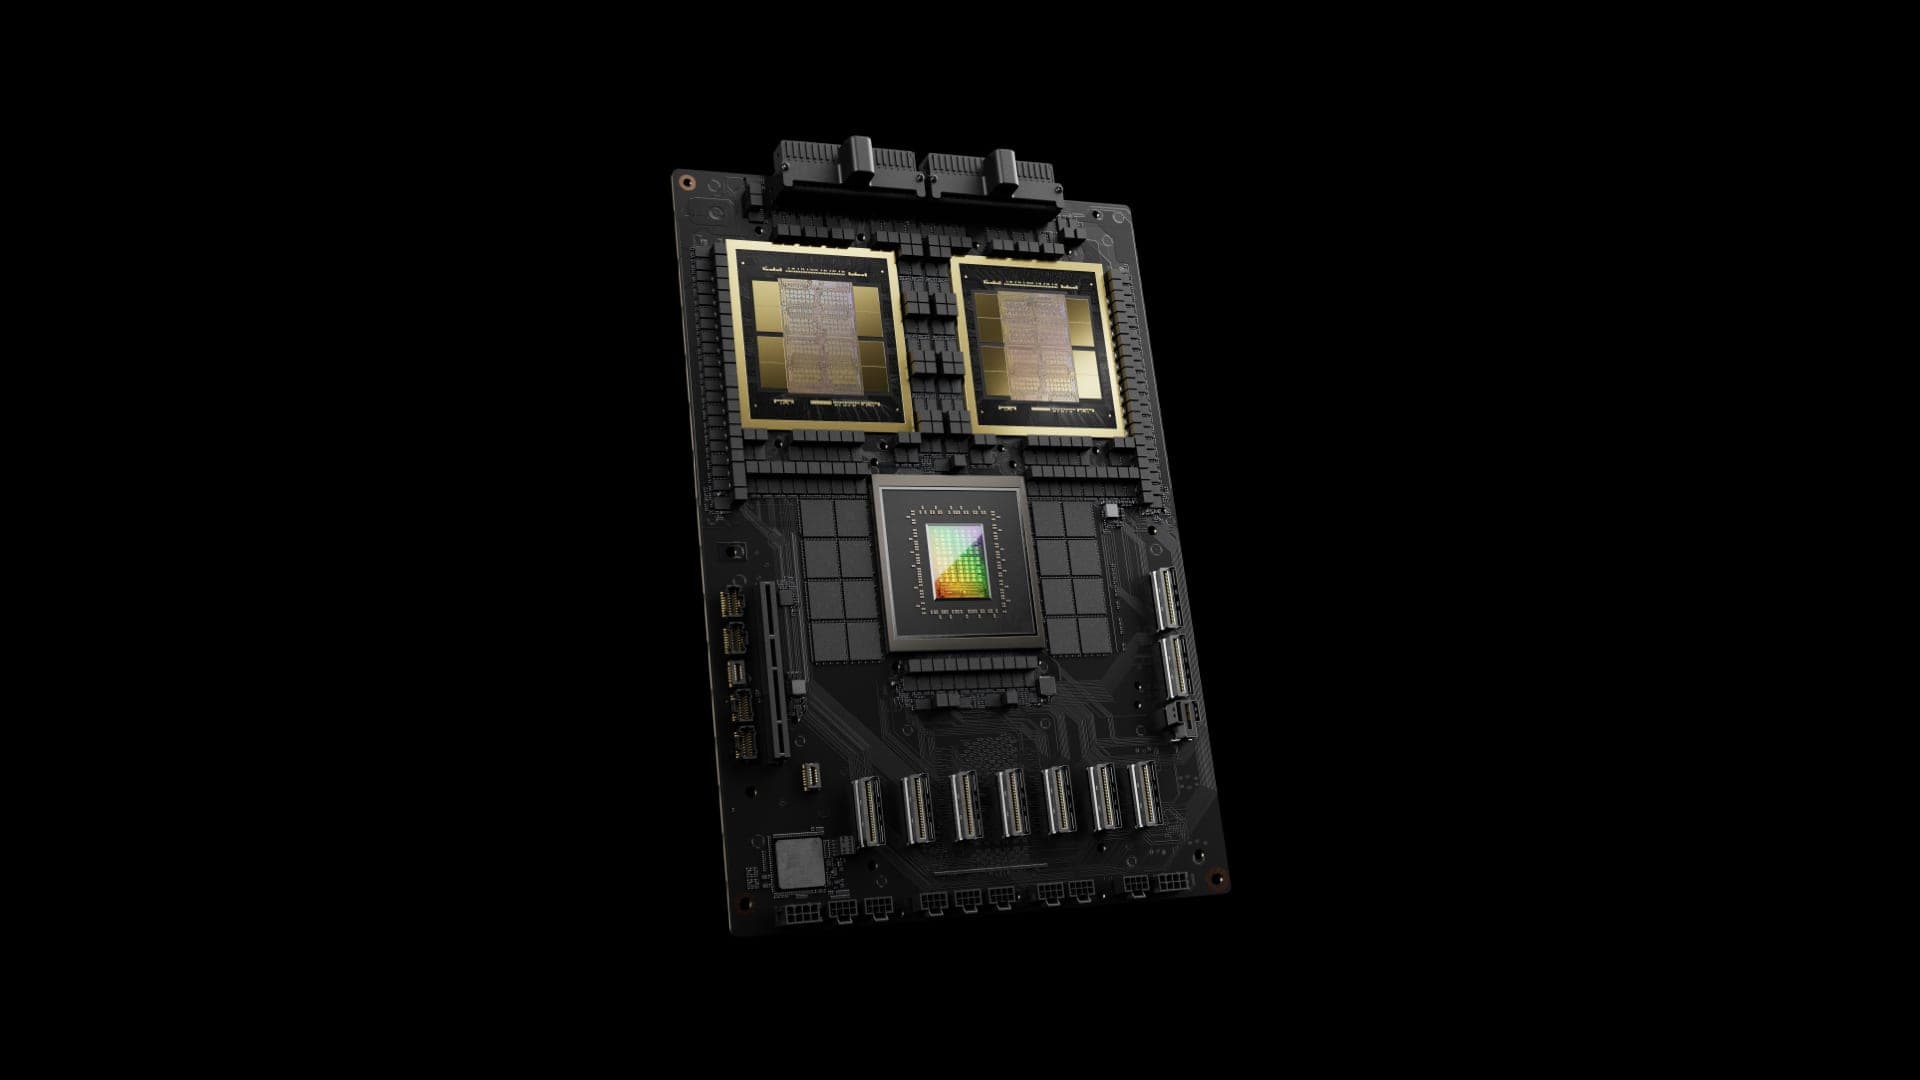
En su presentación, Jensen Huang, consejero delegado de NVIDIA, destacó que se trata de una GPU enorme que puede usarse para construir gigantescos clústeres de ordenadores o un superordenador. Huang presentó el Blackwell Die; en la industria de los semiconductores, «die» se refiere al chip sin encapsular, también llamado chip desnudo. El Blackwell Die es el núcleo de la tarjeta B100: contiene unos 104.000 millones de transistores fabricados con el proceso mejorado de 4 nm de TSMC. La B200 es básicamente la unión de dos chips desnudos B100 en un mismo encapsulado, una técnica parecida a la que usa Apple en su M2 Ultra, aunque la velocidad de transferencia de datos de NVIDIA es muy superior a la de Apple. En número de transistores, la B100 tiene alrededor de un 25 % más que la H100; la B200, al combinar dos chips B100, tiene 2,5 veces más que la H100.
B200
Antes de comparar la capacidad de cálculo de la B200 y la H100, hay que entender los formatos FP4 y FP8. Ambos son formatos de coma flotante para representar números decimales: FP4 usa 4 bits por número y FP8 usa 8 bits, por lo que FP8 ofrece más precisión.
Jensen Huang subrayó la enorme capacidad de cálculo de la GPU B200, que alcanza los 20 petaflops (PFLOPS), cinco veces los 4 PFLOPS de la H100. Pero la comparación es algo engañosa: los 20 PFLOPS de la B200 se miden en FP4, mientras que los 4 PFLOPS de la H100 se miden en FP8. Como FP4 es menos preciso que FP8, comparar directamente los PFLOPS no es del todo justo. Si medimos ambas GPU en FP8, la B200 rinde en realidad 10 PFLOPS frente a los 4 de la H100; la B100 sola, entre 5 y 7 PFLOPS.
Superchips GB200
Huang se centró después en el superchip GB200, que no es un concepto totalmente nuevo, sino una versión mejorada del anterior GH200. El GH200 combinaba una CPU NVIDIA Grace y una GPU H100, mientras que el GB200 da un gran salto: une una CPU Grace y dos GPU Blackwell B200 conectadas mediante NVLink. El nuevo superchip cuenta con hasta 864 GB de memoria: los 384 GB de memoria de alto ancho de banda (HBM) de las dos GPU B200 más 480 GB de la CPU Grace.
Blackwell y GB200 NVL72
NVIDIA presentó el Blackwell Compute Node, un servidor con dos superchips GB200, es decir, cuatro GPU B200 y dos CPU Grace. Esta configuración ofrece más densidad de cálculo que el servidor HGX de la generación anterior: el antiguo HGX solía tener ocho GPU y ocupaba 8U, mientras que el Blackwell Compute Node se ha reducido a 1U o 2U.
La gran novedad es el GB200 NVL72, un sistema en rack en el que «NVL» hace referencia a NVLink, la tecnología de transferencia de datos de alta velocidad de NVIDIA. Un rack NVL72 incluye 18 Blackwell Compute Nodes, cada uno con 4 GPU B200, es decir, 72 GPU B200 en total. Es una mejora enorme frente al rack de la generación H100, en el que cabían como máximo 4 servidores de 8U con 32 GPU.
Transformer Engine 2 y el formato FP4
NVIDIA presentó la segunda generación de su motor de cálculo, Transformer Engine 2, optimizado para grandes modelos de lenguaje y arquitecturas Transformer. Esta tecnología permite a la GPU elegir automáticamente entre FP8 y FP4 según las necesidades del cálculo, lo que aumenta la flexibilidad y la eficiencia. Si una parte del modelo puede calcularse en FP4 sin perder precisión, el sistema cambia automáticamente a FP4 para acelerar el cálculo.
Gran mejora en la eficiencia del entrenamiento
Según Huang, entrenar un modelo GPT de 1,8 billones de parámetros con las antiguas H100 requería 8.000 GPU, 90 días y 15 MW de potencia. Con la nueva arquitectura Blackwell y el GB200, la misma tarea solo necesita 2.000 GPU y se completa en los mismos 90 días, pero con un consumo de solo 4 MW. Tanto el número de GPU como el consumo se reducen a una cuarta parte.
Más allá de la conferencia principal
Además de la presentación de Huang, hubo otras novedades interesantes. NVIDIA lanzó un nuevo servicio de software llamado NIM (NVIDIA Inference Microservice). NIM permite ejecutar directamente en la GPU un contenedor que incluye todo lo necesario para ejecutar IA, sin necesidad de configuración ni instalación manual. Instalado incluso en GPU más antiguas, permite ejecutar modelos de IA y ofrecer los servicios necesarios, con una arquitectura de microservicios para la comunicación entre ellos.
Los avances de NVIDIA en robótica
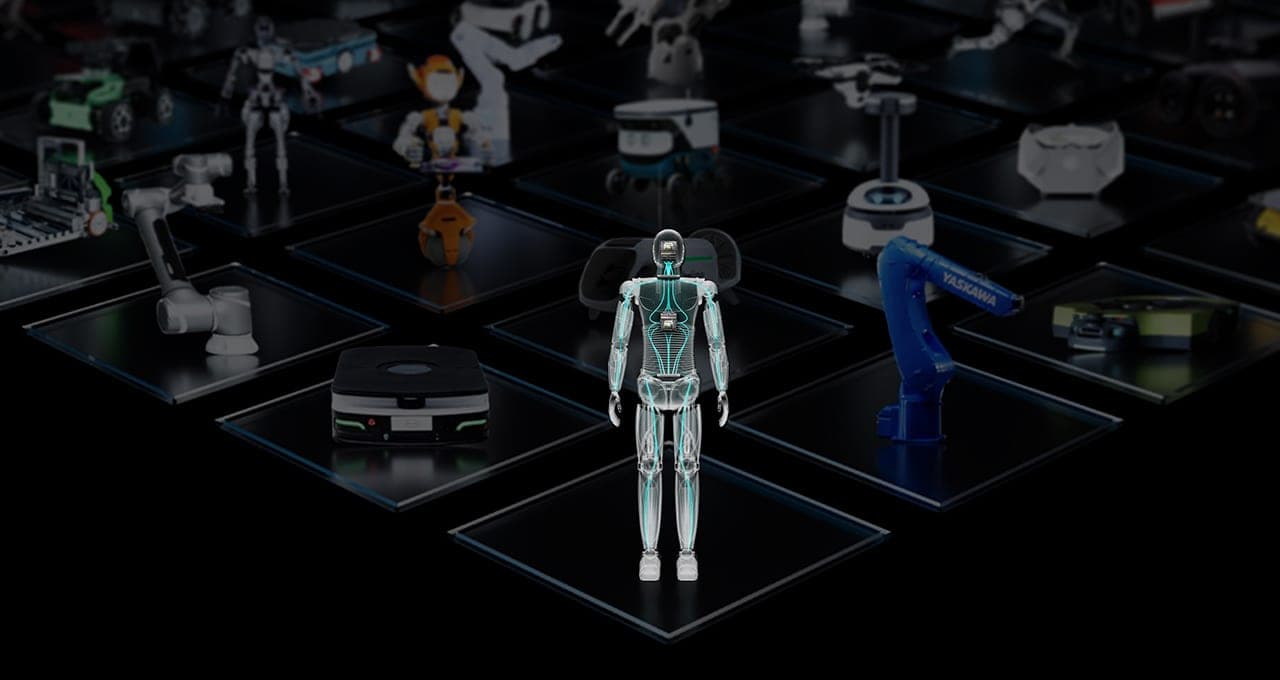
NVIDIA es un actor importante en robótica. En su presentación, Huang mostró una serie de robots humanoides, entre ellos dos pequeños y adorables robots de Disney, lo que sorprendió a muchos que desconocían la implicación de NVIDIA en este campo. Uno de los puntos fuertes de esta GTC en robótica fue la actualización de numerosas funciones de Isaac, la plataforma de desarrollo de robots de NVIDIA. Además, NVIDIA presentó un nuevo modelo fundacional para robots llamado GR00T.
GR00T no es un robot físico, sino el «cerebro» de un robot, con dos funciones principales: comprender el lenguaje humano e imitar acciones humanas mediante el aprendizaje. A muchos les impresiona GR00T, pero es más bien un «modelo genérico»: NVIDIA entrena este modelo fundacional para que cualquier fabricante interesado en desarrollar robots humanoides pueda usarlo y luego afinarlo para comercializarlo o aplicarlo en productos reales. Su posicionamiento es distinto del de Optimus: sirve sobre todo como modelo base para otros fabricantes. Por hacer una analogía, GR00T se parece a Llama 2 de Meta: tiene capacidad suficiente para ayudar, con un modelo genérico, a los fabricantes de robots que no pueden desarrollar su propio «cerebro».