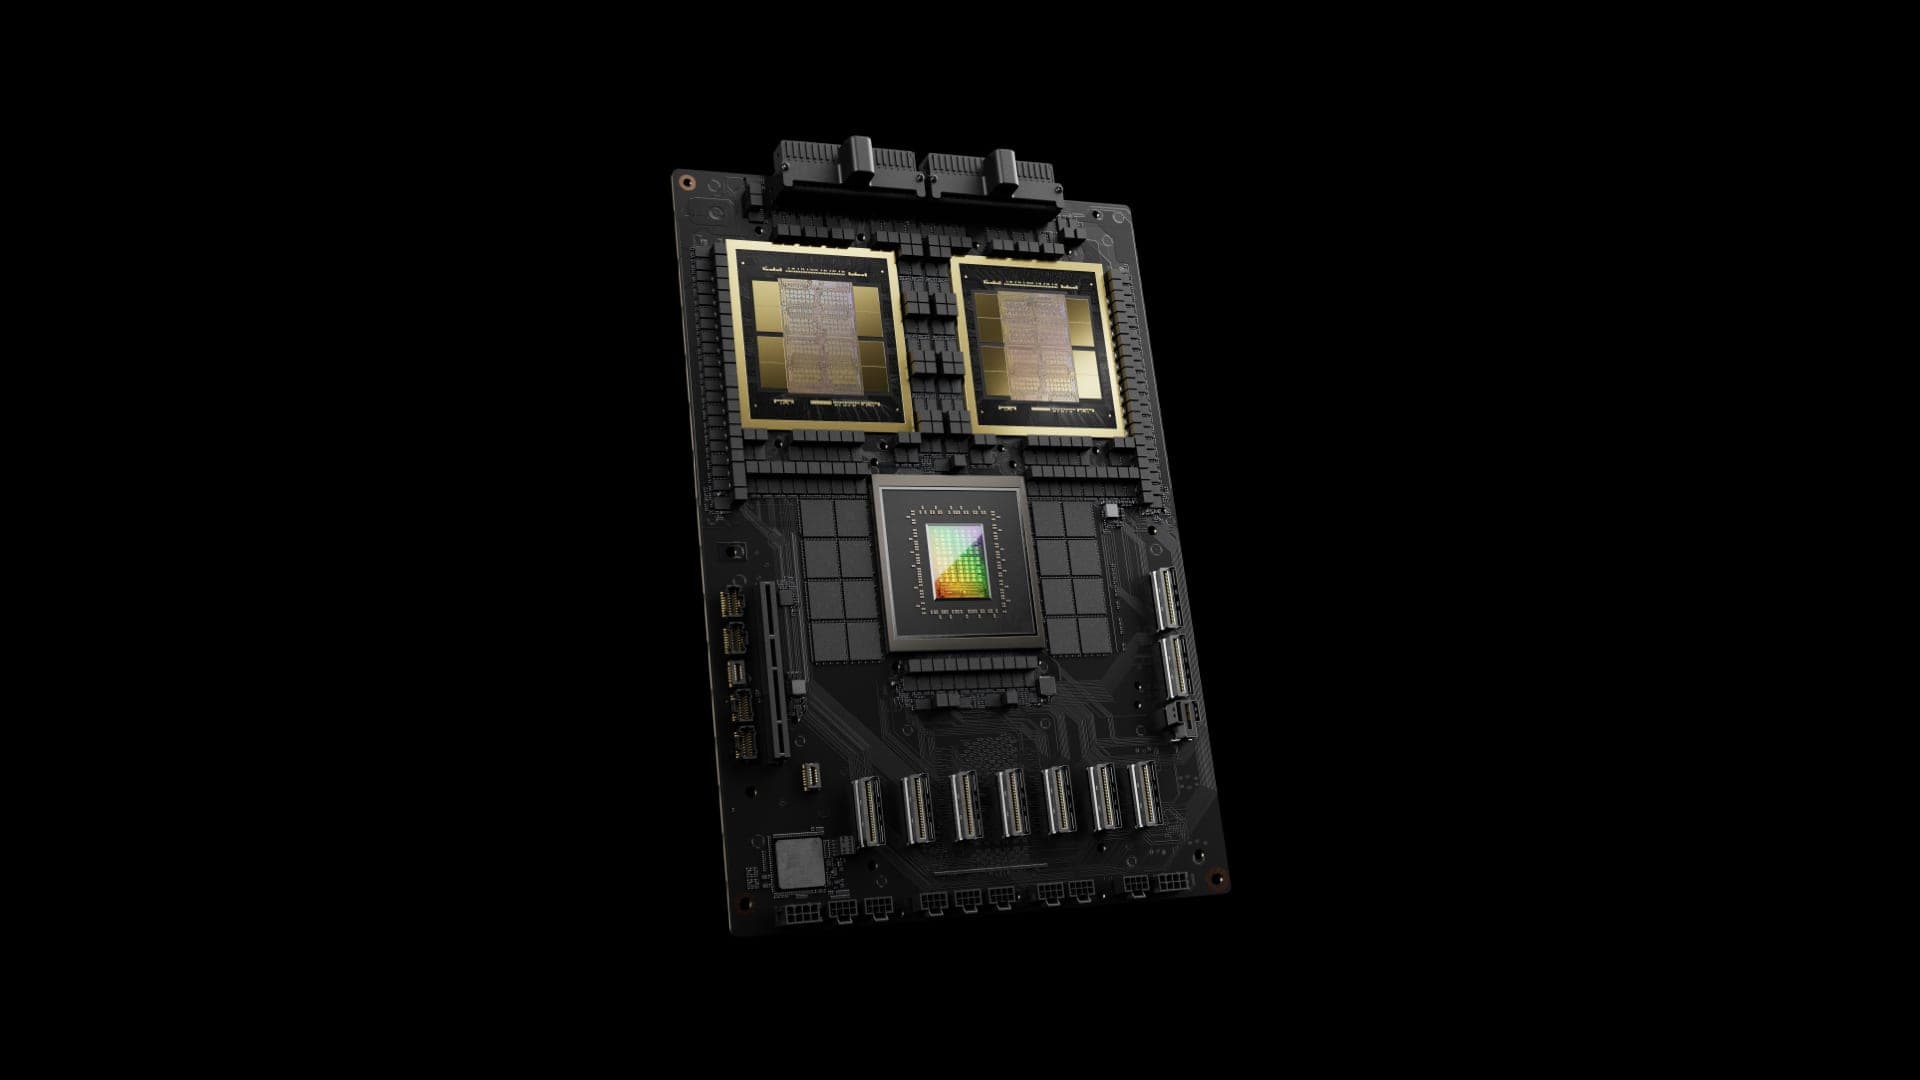
NVIDIA hat auf der jüngsten GTC (GPU Technology Conference) mehrere wichtige Neuheiten angekündigt. Zunächst brachte das Unternehmen offiziell seine nächste KI-GPU-Generation auf den Markt: die Blackwell B100. Die Keynote stellte jedoch die gesamte Blackwell-Plattform in den Mittelpunkt statt nur die Grafikkarte B100.
InhaltsverzeichnisAnzeigenAusblenden
Der Blackwell-Die und die B100-GPU
Bei der Vorstellung betonte NVIDIA-CEO Jensen Huang, dass es sich um eine riesige GPU handelt, mit der sich gewaltige Rechencluster oder Supercomputer bauen lassen. Huang präsentierte den Blackwell-Die – in der Halbleiterbranche bezeichnet „Die“ einen ungehäusten Chip, auch Nacktchip genannt. Der Blackwell-Die ist das Herzstück der B100: Er enthält rund 104 Milliarden Transistoren, gefertigt im verbesserten 4-nm-Verfahren von TSMC. Die B200 kombiniert im Wesentlichen zwei B100-Dies in einem Gehäuse – ähnlich der Technik, die Apple beim M2 Ultra nutzt, allerdings mit einer deutlich höheren Datenübertragungsrate. Bei der Transistorzahl liegt die B100 etwa 25 % über der H100; die B200 kommt durch die zwei kombinierten Dies auf das 2,5-Fache der H100.
B200
Bevor man die Rechenleistung von B200 und H100 vergleicht, muss man die Formate FP4 und FP8 verstehen. Beide sind Gleitkommaformate zur Darstellung von Dezimalzahlen: FP4 nutzt 4 Bit pro Zahl, FP8 8 Bit – FP8 ist daher genauer.
Jensen Huang hob die deutlich gesteigerte Rechenleistung der B200 hervor: 20 Petaflops (PFLOPS), fünfmal so viel wie die 4 PFLOPS der H100. Der Vergleich ist jedoch etwas irreführend, denn die 20 PFLOPS der B200 beziehen sich auf FP4, die 4 PFLOPS der H100 dagegen auf FP8. Da FP4 ungenauer ist als FP8, ist ein direkter Vergleich nicht ganz fair. Misst man beide in FP8, erreicht die B200 tatsächlich 10 PFLOPS gegenüber 4 PFLOPS der H100; die B100 allein kommt auf 5 bis 7 PFLOPS.
GB200-Superchips
Als Nächstes stellte Huang den GB200-Superchip vor – kein völlig neues Konzept, sondern eine verbesserte Version des GH200. Der GH200 kombinierte eine NVIDIA-Grace-CPU mit einer H100-GPU; der GB200 legt deutlich zu und verbindet eine Grace-CPU mit zwei Blackwell-B200-GPUs per NVLink. Der neue Superchip bietet bis zu 864 GB Speicher: die 384 GB High Bandwidth Memory (HBM) der beiden B200-GPUs plus 480 GB auf der Grace-CPU.
Blackwell und GB200 NVL72
NVIDIA präsentierte den Blackwell Compute Node, einen Server mit zwei GB200-Superchips – also vier B200-GPUs und zwei Grace-CPUs. Diese Konfiguration bietet eine höhere Rechendichte als der HGX-Server der Vorgängergeneration: Der alte HGX hatte meist acht GPUs bei 8 Höheneinheiten (8U), der Blackwell Compute Node kommt mit 1U oder 2U aus.
Die große Neuheit ist das GB200 NVL72, ein Rack-System, bei dem „NVL“ für NVLink steht, NVIDIAs Technologie für schnelle Datenübertragung. Ein NVL72-Rack enthält 18 Blackwell Compute Nodes mit je 4 B200-GPUs – insgesamt also 72 B200-GPUs. Das ist ein enormer Fortschritt gegenüber dem H100-Rack der Vorgängergeneration, in das höchstens vier 8U-Server mit 32 GPUs passten.
Transformer Engine 2 und das FP4-Format
NVIDIA stellte die zweite Generation seiner Recheneinheit vor, die Transformer Engine 2, optimiert für große Sprachmodelle und Transformer-Architekturen. Damit kann die GPU je nach Bedarf automatisch zwischen FP8 und FP4 wählen, was Flexibilität und Effizienz erhöht. Lässt sich ein Teil eines Modells ohne Genauigkeitsverlust in FP4 berechnen, schaltet das System automatisch auf FP4 um und beschleunigt die Berechnung.
Deutlich effizienteres Modelltraining
Laut Huang benötigte das Training eines GPT-Modells mit 1,8 Billionen Parametern mit den alten H100-GPUs 8.000 GPUs, 90 Tage und 15 MW Leistung. Mit der neuen Blackwell-Architektur und dem GB200 braucht dieselbe Aufgabe nur 2.000 GPUs, ist ebenfalls in 90 Tagen erledigt und verbraucht nur 4 MW. Sowohl die Zahl der GPUs als auch der Stromverbrauch sinken auf ein Viertel.
Highlights jenseits der Keynote
Neben Huangs Keynote gab es weitere spannende Neuigkeiten. NVIDIA hat einen neuen Softwaredienst namens NIM (NVIDIA Inference Microservice) vorgestellt. Mit NIM lässt sich ein Container direkt auf der GPU ausführen, der alles für den KI-Betrieb Nötige enthält – ohne manuelle Einrichtung und Installation. Selbst auf älteren GPUs installiert, lassen sich damit KI-Modelle betreiben und die benötigten Dienste bereitstellen, wobei die Kommunikation über eine Microservice-Architektur läuft.
NVIDIAs Fortschritte in der Robotik
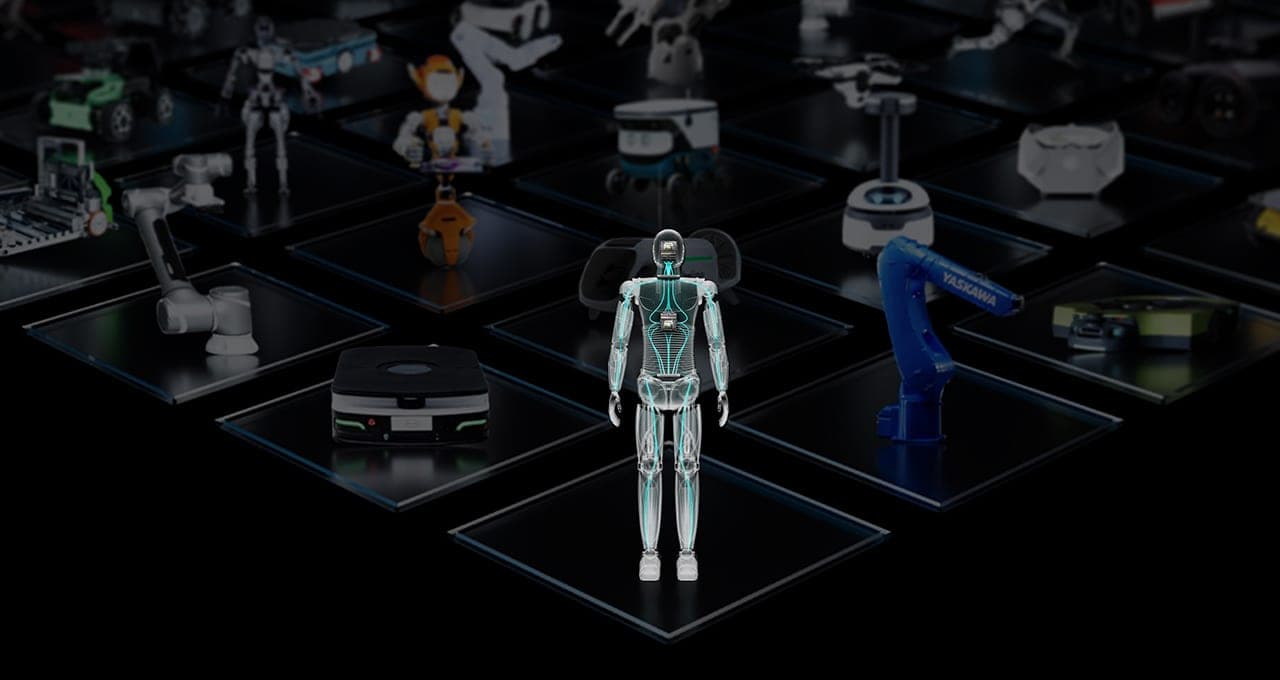
NVIDIA ist ein wichtiger Akteur in der Robotik. In seiner Präsentation zeigte Huang eine Reihe humanoider Roboter, darunter zwei kleine, niedliche Disney-Roboter – zur Überraschung vieler, die nichts von NVIDIAs Robotik-Engagement wussten. Ein Robotik-Highlight dieser GTC war das Update zahlreicher Funktionen von Isaac, NVIDIAs Plattform für die Roboterentwicklung. Außerdem stellte NVIDIA ein neues Basismodell für Roboter vor: GR00T.
GR00T ist kein physischer Roboter, sondern das „Gehirn“ eines Roboters mit zwei Hauptfunktionen: menschliche Sprache verstehen und menschliche Bewegungen durch Lernen nachahmen. Viele finden GR00T beeindruckend, doch es ist eher ein „generisches Modell“: NVIDIA trainiert dieses Basismodell, damit alle Hersteller, die humanoide Roboter entwickeln wollen, es nutzen und für ihre Produkte feinabstimmen können. Damit unterscheidet sich GR00T von Optimus – es dient vor allem anderen Herstellern als Basismodell. Vergleichbar ist GR00T mit Metas Llama 2: leistungsfähig genug, um Roboterherstellern, die kein eigenes „Gehirn“ entwickeln können, mit einem generischen Modell zu helfen.