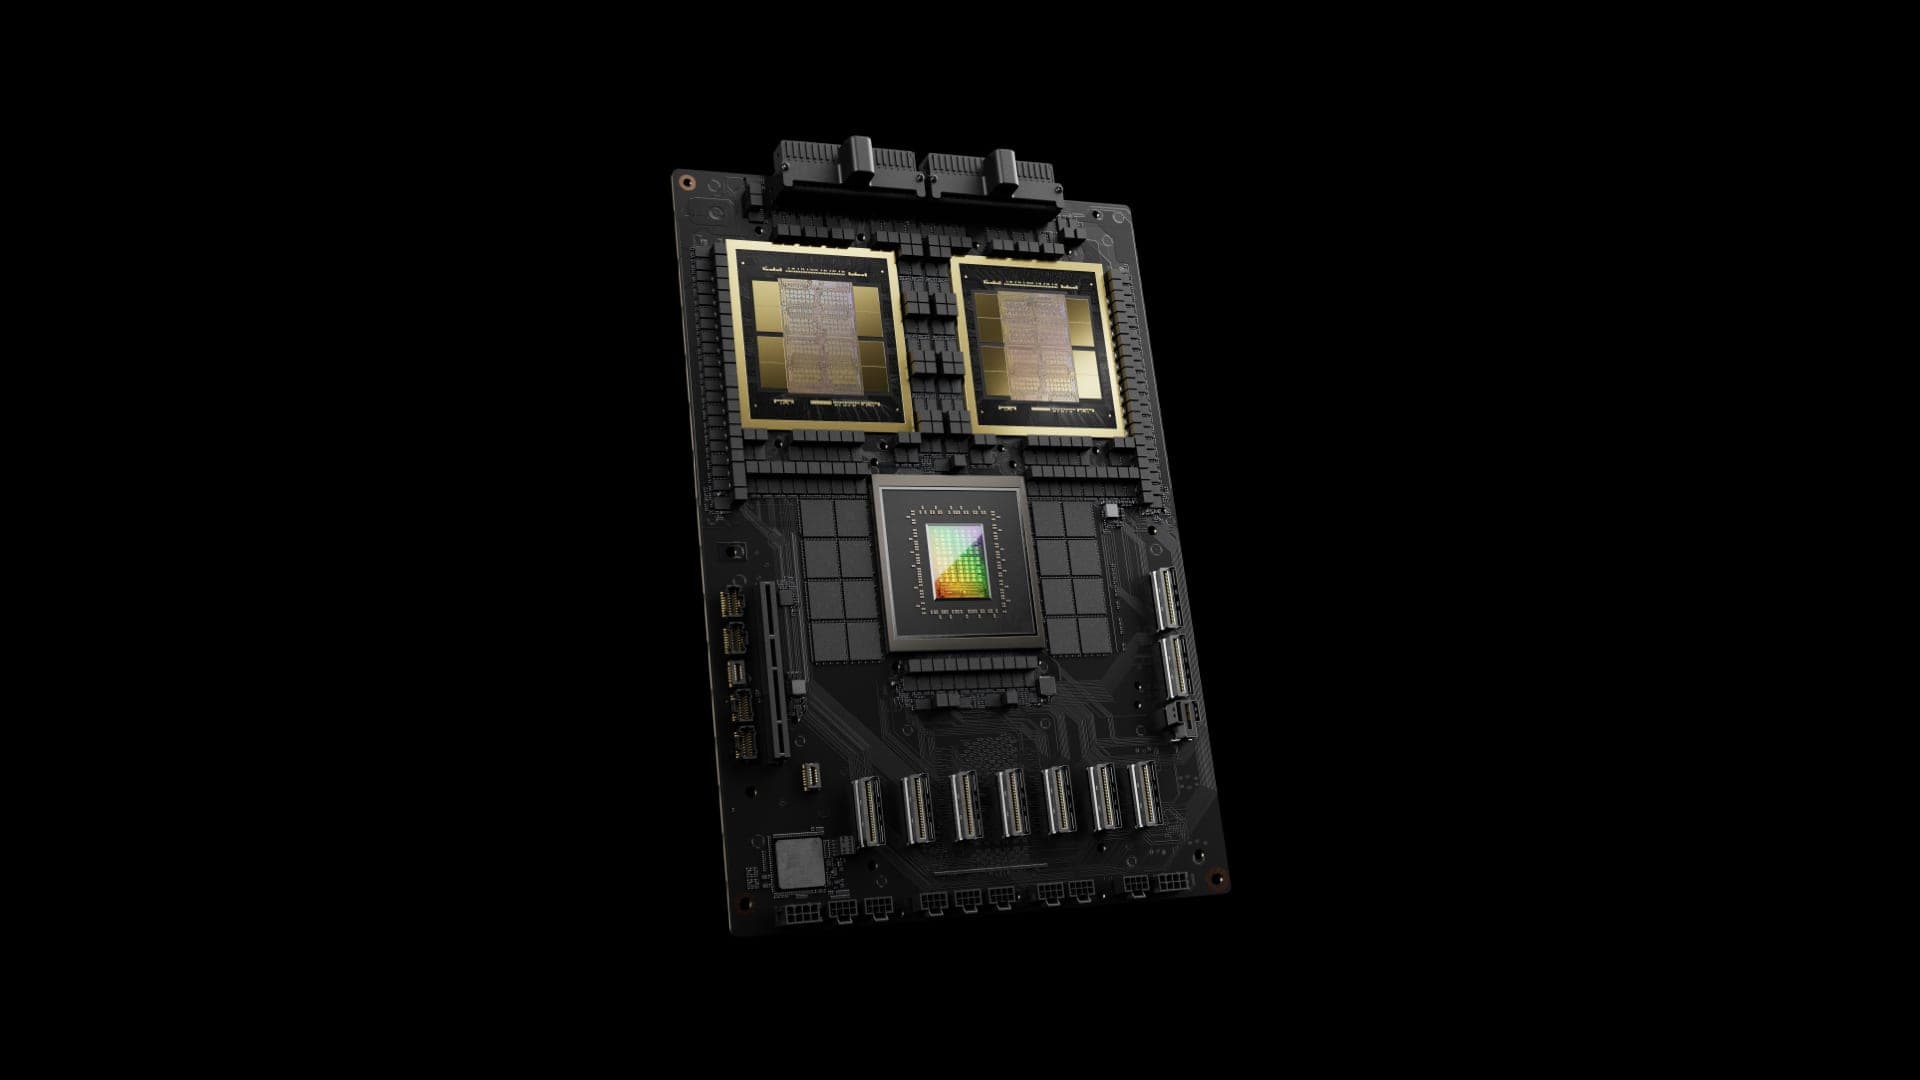
NVIDIA a fait plusieurs annonces majeures lors de la dernière GTC (GPU Technology Conference). D’abord, l’entreprise a officiellement lancé son GPU d’IA de nouvelle génération, le Blackwell B100. La keynote a toutefois mis en avant toute la plateforme Blackwell plutôt que la seule carte graphique B100.
SommaireAfficherMasquer
La puce Blackwell et le GPU B100
Lors de sa présentation, Jensen Huang, PDG de NVIDIA, a souligné qu’il s’agit d’un GPU gigantesque, capable de servir à bâtir d’immenses grappes de calcul ou un supercalculateur. Il a présenté le Blackwell Die ; dans l’industrie des semi-conducteurs, le « die » désigne une puce non encapsulée, aussi appelée puce nue. Le Blackwell Die est le cœur de la carte B100 : il contient environ 104 milliards de transistors gravés avec le procédé 4 nm amélioré de TSMC. La B200 réunit essentiellement deux puces nues B100 dans un même boîtier, une technique proche de celle d’Apple pour son M2 Ultra, avec toutefois un débit de transfert de données bien plus élevé chez NVIDIA. En nombre de transistors, la B100 en compte environ 25 % de plus que la H100 ; la B200, qui combine deux puces B100, en compte 2,5 fois plus que la H100.
B200
Avant de comparer la puissance de calcul de la B200 et de la H100, il faut comprendre les formats FP4 et FP8. Ce sont deux formats à virgule flottante pour représenter les nombres décimaux : FP4 utilise 4 bits par nombre, FP8 en utilise 8, d’où une précision supérieure pour FP8.
Jensen Huang a insisté sur la puissance de calcul nettement accrue du GPU B200, qui atteint 20 pétaflops (PFLOPS), soit cinq fois les 4 PFLOPS de la H100. Mais la comparaison est un peu trompeuse : les 20 PFLOPS de la B200 sont mesurés en FP4, alors que les 4 PFLOPS de la H100 le sont en FP8. FP4 étant moins précis que FP8, comparer directement les PFLOPS n’est pas tout à fait équitable. En FP8 pour les deux, la B200 atteint en réalité 10 PFLOPS contre 4 pour la H100 ; la B100 seule se situe entre 5 et 7 PFLOPS.
Les superpuces GB200
Jensen Huang s’est ensuite concentré sur la superpuce GB200, qui n’est pas un concept entièrement nouveau mais une version améliorée de la GH200. La GH200 associait un processeur NVIDIA Grace à un GPU H100 ; la GB200 franchit un cap en associant un processeur Grace à deux GPU Blackwell B200, reliés par NVLink. La nouvelle superpuce dispose de jusqu’à 864 Go de mémoire : les 384 Go de mémoire à haute bande passante (HBM) des deux GPU B200, plus 480 Go côté processeur Grace.
Blackwell et GB200 NVL72
NVIDIA a présenté le Blackwell Compute Node, un serveur qui accueille deux superpuces GB200, soit quatre GPU B200 et deux processeurs Grace. Cette configuration offre une densité de calcul supérieure à celle du serveur HGX de génération précédente : l’ancien HGX comptait généralement huit GPU pour un format 8U, alors que le Blackwell Compute Node tient en 1U ou 2U.
La grande nouveauté est le GB200 NVL72, un système en baie dont le « NVL » fait référence à NVLink, la technologie de transfert de données à haut débit de NVIDIA. Une baie NVL72 accueille 18 Blackwell Compute Nodes de 4 GPU B200 chacun, soit 72 GPU B200 au total. C’est un progrès considérable par rapport à la baie H100 de génération précédente, qui pouvait contenir au maximum 4 serveurs 8U, soit 32 GPU.
Transformer Engine 2 et le format FP4
NVIDIA a présenté la deuxième génération de son moteur de calcul, Transformer Engine 2, optimisé pour les grands modèles de langage et les architectures Transformer. Cette technologie permet au GPU de choisir automatiquement entre FP8 et FP4 selon les besoins, ce qui accroît la souplesse et l’efficacité des calculs. Si une partie d’un modèle peut être calculée en FP4 sans perte de précision, le système bascule automatiquement en FP4 pour accélérer le calcul.
Une efficacité d’entraînement nettement améliorée
Selon Jensen Huang, entraîner un modèle GPT de 1 800 milliards de paramètres avec les anciens GPU H100 nécessitait 8 000 GPU, 90 jours et 15 MW de puissance. Avec la nouvelle architecture Blackwell et la GB200, la même tâche ne demande que 2 000 GPU, dans le même délai de 90 jours, pour une consommation de seulement 4 MW. Le nombre de GPU comme la consommation sont divisés par quatre.
Au-delà de la keynote
Au-delà de la présentation de Jensen Huang, d’autres annonces ont retenu l’attention. NVIDIA a lancé un nouveau service logiciel, NIM (NVIDIA Inference Microservice). NIM permet d’exécuter directement sur le GPU un conteneur qui regroupe tout le nécessaire pour faire tourner l’IA, sans configuration ni installation manuelles. Installé même sur des GPU plus anciens, il permet d’exécuter des modèles d’IA et de fournir les services nécessaires, avec une architecture de microservices pour la communication entre eux.
Les progrès de NVIDIA en robotique
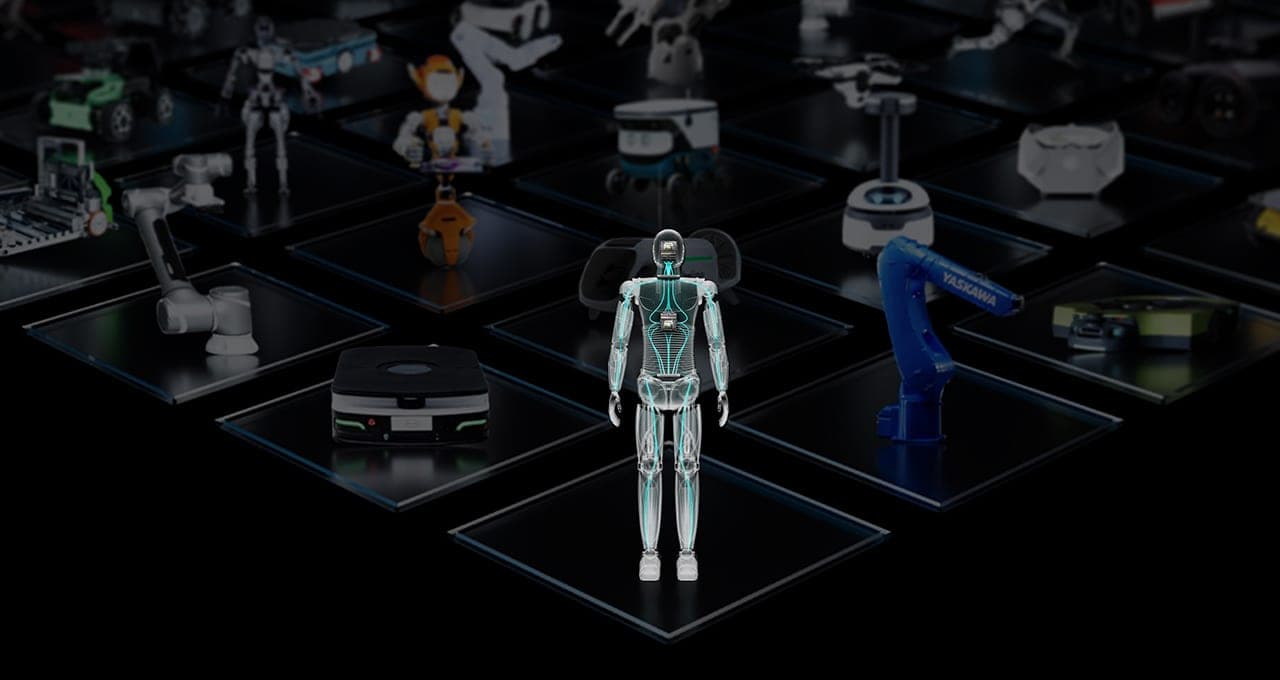
NVIDIA est un acteur important de la robotique. Pendant sa présentation, Jensen Huang a montré une série de robots humanoïdes, dont deux petits robots Disney adorables, à la surprise de nombreux spectateurs qui ignoraient l’implication de NVIDIA dans ce domaine. L’un des temps forts de cette GTC en robotique a été la mise à jour de nombreuses fonctions d’Isaac, la plateforme de développement robotique de NVIDIA. NVIDIA a aussi présenté un nouveau modèle de fondation pour robots, baptisé GR00T.
GR00T n’est pas un robot physique, mais le « cerveau » d’un robot, avec deux fonctions principales : comprendre le langage humain et imiter les gestes humains par apprentissage. Beaucoup trouvent GR00T impressionnant, mais il s’agit plutôt d’un « modèle générique » : NVIDIA entraîne ce modèle de fondation pour que tous les fabricants intéressés par les robots humanoïdes puissent l’utiliser, puis l’affiner pour le commercialiser ou l’intégrer à de vrais produits. Son positionnement diffère de celui d’Optimus : il sert avant tout de modèle de base pour d’autres fabricants. Par analogie, GR00T ressemble à Llama 2 de Meta : il est assez performant pour aider, grâce à un modèle générique, les fabricants de robots incapables de développer leur propre « cerveau ».